LLMwiki
最开始我个人以为这是一个rag知识库的新范式。学习后,发现其是一篇维护小型知识库的最佳实践。特别适合解决当下agents中对于知识库的维护问题。
26年4月,karpathy在x上分享出自己的通过llm构建出知识库的方法后,推文获得了极大的关注,随后他整理优化了自己的知识库搭建方式,发布了这个md介绍了自己搭建方法。
核心方法
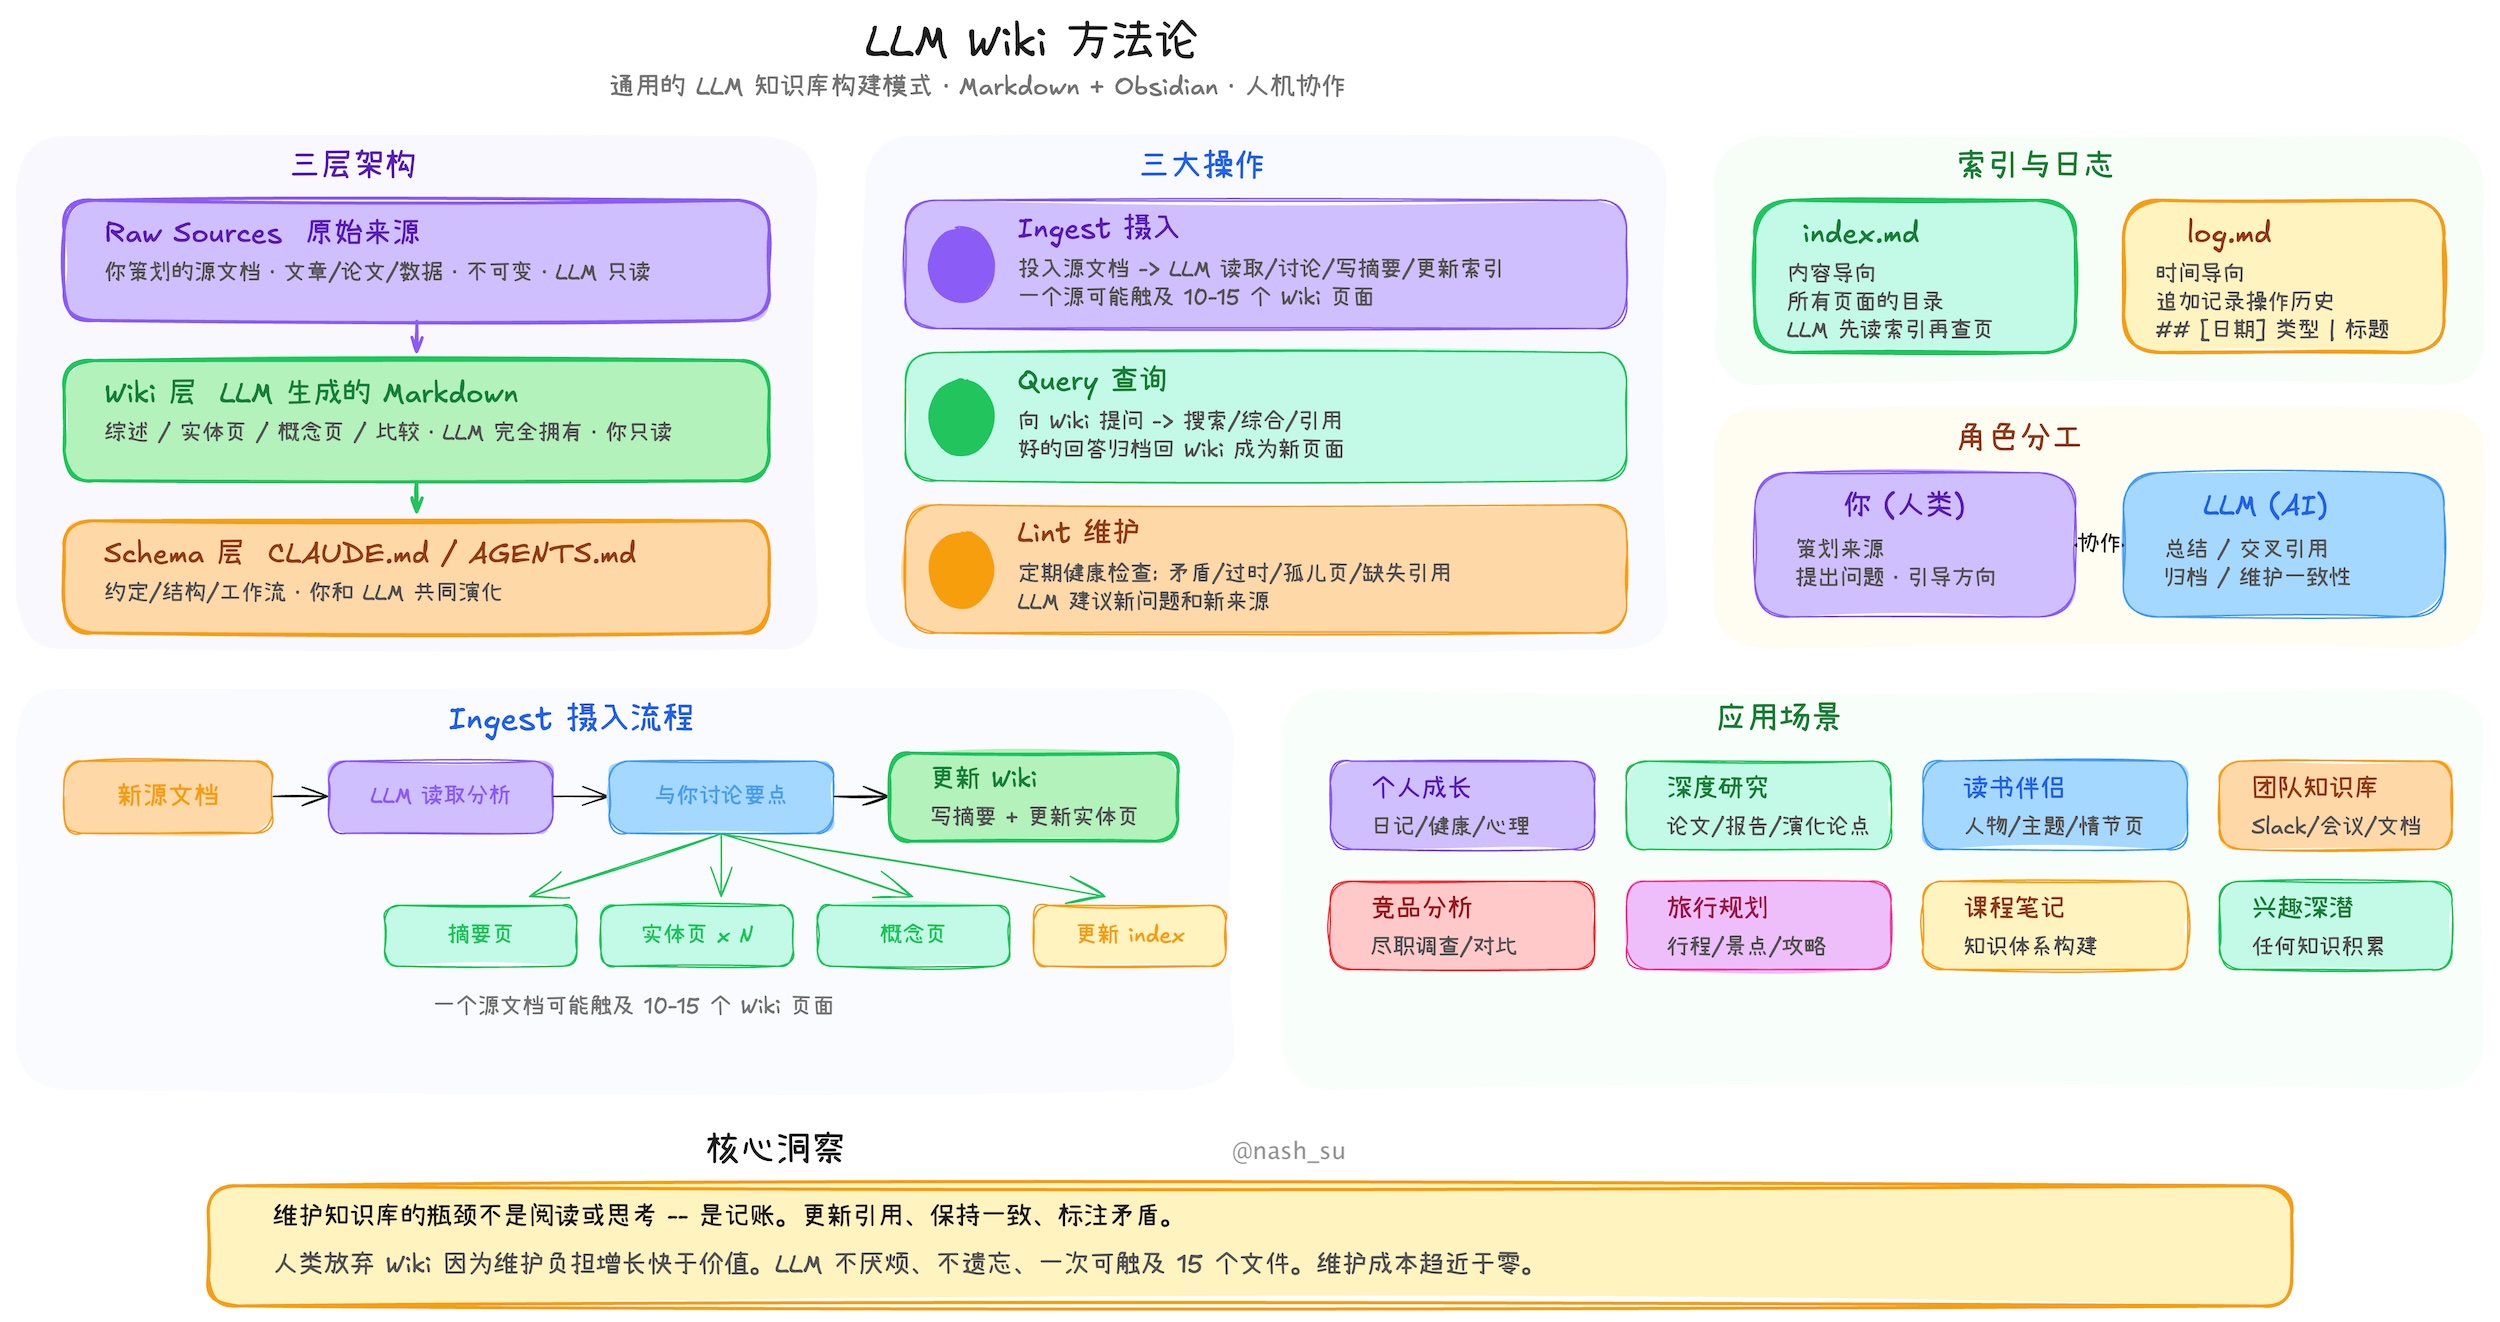
通过2个文件夹+1个约束文件来实现:
raw:用于存放自己的原始的知识,比如:图片、网页转成的md、数据等。
wiki:主要包含llm整理出来的一些md文件,其内存储以下文件:
两个特殊文件:
index.md:内容目录,列出所有页面、链接、一行摘要和元数据。log.md:按时间追加的操作日志,记录摄取、查询、lint 等。
若干内容页面:摘要页、实体页、概念页、比较页、概览页、综合页等。数量随来源增长,一个来源可能触及 10–15 个 wiki 页面。
Schema: 一个md文件,它告诉 LLM:wiki 如何组织、页面格式、命名约定、摄取/查询/lint 工作流。
关于Schema的一点想法:
karpathy在写这个llmwiki的文档的时候,是在做一个持续了超过1个月的研究工作,个人认为其使用codex或者claude的工具的时候,工作目录下就是这2个文件夹+1个schema(可能是AGENTS.md或者CLAUDE.md)。而在我们常用的编码场景,可以把这个文件转为一个skills,而文件夹可以在用户的主目录或者agents当前所在的目录。
维护流程
将文档加入知识库(ingest):告诉llm,你要加入知识库的文档,llm对新的文档进行解析、整理必要的元数据,同时检查是否与已有的资料存在矛盾。
搜索
维护(Lint): 定期让 LLM 对 wiki 做健康检查。处理页面之间的矛盾、移除过时的信息、没有加入索引的的孤儿页面、被提到但没有自己页面的重要概念、缺失的交叉引用、可以通过网络搜索填补的数据空白。使 wiki 在增长过程中保持健康。
适用范围与局限性思考
作者推荐将这个思路可以使用到以下场景中:
个人:跟踪你自己的目标、健康、心理、自我提升——归档日记条目、文章、播客笔记,并随着时间构建一个关于你自己的结构化图景。
研究:在数周或数月内深入研究一个主题——阅读论文、文章、报告,并增量构建一个带有不断演进论点的综合 wiki。
阅读一本书:随着阅读逐章归档,构建角色、主题、情节线索及其如何连接的页面。到最后你就有了一个丰富的 companion wiki。想想像 Tolkien Gateway 这样的粉丝 wiki——成千上万个相互链接的页面,覆盖角色、地点、事件、语言,由志愿者社区多年构建。你可以在阅读时个人构建类似的东西,由 LLM 完成所有交叉引用和维护。
商业/团队:由 LLM 维护的内部 wiki,输入来自 Slack 线程、会议转录、项目文档、客户电话。可能还有人类在环中审查更新。wiki 保持最新,因为 LLM 做了团队中没人想做的维护工作。
竞争分析、尽职调查、旅行规划、课程笔记、爱好深度探索——任何你随着时间积累知识并希望它被组织起来而不是散落各处的场景。
与rag相比,其因为索引的持续增加,会导致占用agent的上下文越来越大,因此如果想在较大的知识库中使用,必须得采用一些优化的策略。
选择维度
知识规模:通过索引优化以及其他的方式,可以使得wiki能够支持的数据量较高,但是知识越多,在维护的时候成本也就越高,在知识规模较小,更新频率不是特别高的情况下比较合适。
搭建:llmwiki搭建简单,只需要模型和几个文件夹以及一些规则约束,就可以。省去了向量库和向量模型。
混合使用的一种方案:
固定的通用的知识使用llmwiki,变化大的使用rag,也可以定期把rag中的一些知识更新到llmwiki
相关参考: